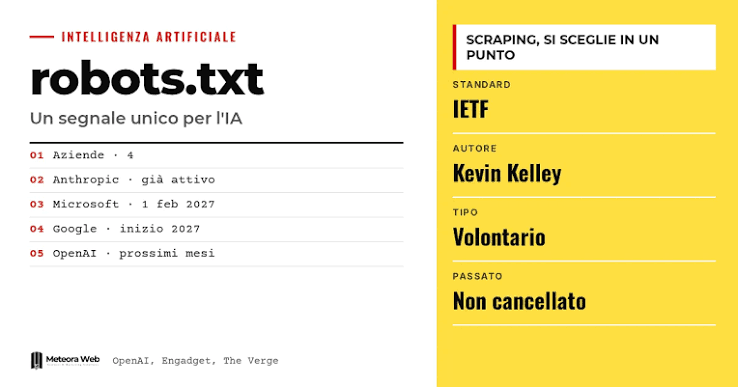
Một bước ngoặt lịch sử vừa diễn ra trong cuộc chiến bản quyền nội dung số giữa các nhà phát triển trí tuệ nhân tạo và cộng đồng quản trị mạng toàn cầu. Bốn thế lực công nghệ lớn nhất thế giới hiện nay gồm OpenAI, Google, Microsoft và Anthropic đã chính thức ngồi lại với nhau để thống nhất một quy chuẩn chung mang tên __usage_ai-training. Thỏa thuận này cho phép các chủ sở hữu trang web, blogger và nhà sáng tạo nội dung chỉ cần viết đúng một dòng lệnh duy nhất để yêu cầu toàn bộ các hệ thống AI không được tự ý lấy bài viết của mình đi đào tạo mô hình.
Chấm dứt cơn ác mộng rượt đuổi hàng tá bot cào dữ liệu
Suốt hai năm bùng nổ của trí tuệ nhân tạo sinh số, các nhà sáng tạo nội dung và quản trị viên website luôn rơi vào thế rượt đuổi bất tận đầy mệt mỏi. Cứ mỗi khi một công ty AI mới xuất hiện, họ lại phải vội vã cập nhật tệp robots.txt để chặn riêng từng con bot: nào là GPTBot của OpenAI, Google-Extended của Google, ClaudeBot của Anthropic, rồi đến hàng loạt cái tên xa lạ khác.
Danh sách chặn ngày càng dài dòng và rối rắm, trong khi các trang web nhỏ lẻ không đủ đội ngũ kỹ thuật để theo dõi danh sách bot mới ra mắt mỗi tuần. Với thỏa thuận mang tính đột phá này, cơn ác mộng trên đã chính thức chấm dứt. Bằng cách sử dụng token tiêu chuẩn __usage_ai-training, một lệnh cấm duy nhất giờ đây sẽ có hiệu lực đồng thời với tất cả các mô hình AI thuộc liên minh bốn ông lớn nói trên.
Cú pháp hai dòng lệnh đơn giản bảo vệ tài sản số
Cách thiết lập cơ chế bảo vệ mới vô cùng đơn giản và thân thuộc với bất kỳ ai từng quản trị website. Người dùng chỉ cần mở tệp robots.txt đặt tại thư mục gốc của trang web và chèn thêm hai dòng lệnh ngắn gọn:
User-Agent: __usage_ai-training
Disallow: /
Ngay khi nhận diện được dòng khai báo này, các thuật toán thu thập dữ liệu của OpenAI, Google, Microsoft và Anthropic sẽ tự động hiểu rằng toàn bộ các bài viết, hình ảnh và tài liệu trên website đó được chủ sở hữu từ chối cấp phép huấn luyện AI. Nếu muốn cho phép AI học các bài viết công khai nhưng bảo vệ các chuyên mục trả phí hoặc tài liệu lưu trữ nhạy cảm, người quản trị chỉ cần giới hạn phạm vi cấm theo từng đường dẫn thư mục cụ thể một cách linh hoạt.
Những giới hạn quan trọng mà nhà sáng tạo cần lưu ý
Mặc dù đây là một thắng lợi lớn cho cộng đồng sáng tạo nội dung, người dùng vẫn cần tỉnh táo nắm rõ những giới hạn của công cụ này. Thứ nhất, token mới chỉ có tác dụng ngăn chặn các công ty AI sử dụng dữ liệu để huấn luyện mô hình thế hệ tiếp theo trong tương lai, chứ không thể xóa bỏ dữ liệu của bạn đã lỡ nằm trong các mô hình đã ra mắt từ trước.
Thứ hai, lệnh chặn này không cấm việc các công cụ tìm kiếm thu thập dữ liệu để hiển thị kết quả tìm kiếm thông thường. Đồng thời, liên minh này hiện vẫn chưa có sự tham gia của Meta (Facebook), Apple hay các công ty công nghệ độc lập khác. Dẫu vậy, việc bốn gã khổng lồ AI cùng đồng lòng thiết lập một tiếng nói chung đã mở ra kỷ nguyên mới công bằng và tôn trọng bản quyền hơn cho toàn bộ không gian Internet.