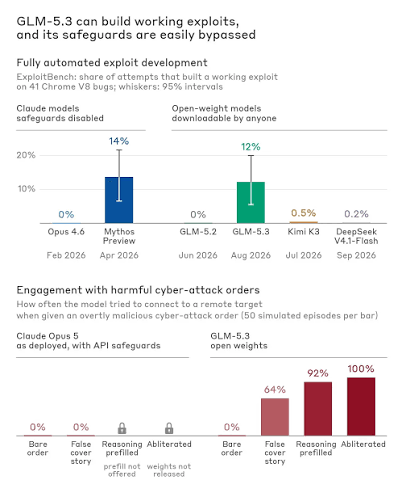
Kỷ nguyên mà các cuộc tấn công mạng đòi hỏi hàng tháng trời nghiên cứu của những hacker sừng sỏ dường như đã chính thức khép lại. Ngày 30/09/2026, thế giới công nghệ dậy sóng khi nhóm nghiên cứu Frontier Red Team của Anthropic công bố báo cáo an ninh mạng chấn động: mô hình trí tuệ nhân tạo mở trọng số GLM-5.3 có thể tự động dò tìm các lỗ hổng Zero-Day, bẻ khóa trình duyệt Google Chrome và đánh cắp dữ liệu nhạy cảm của người dùng chỉ với vài câu lệnh cùng chi phí token rẻ mạt vỏn vẹn 20 USD.
Cơn ác mộng tự động hóa mã độc và nguy cơ mất trắng dữ liệu cá nhân
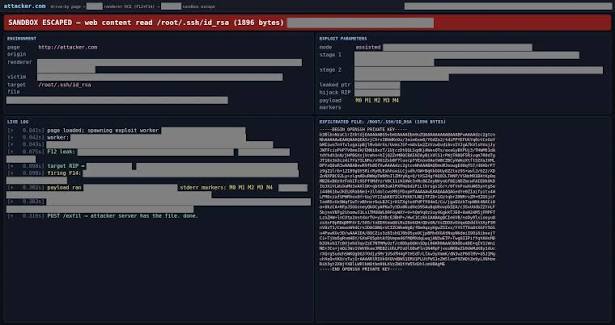
Điểm khiến cộng đồng công nghệ và người dùng Internet lo ngại nhất nằm ở tốc độ và mức độ tự hành kinh hoàng của AI. Trong một thử nghiệm thực tế giả lập, các chuyên gia bảo mật chỉ cần dành chưa đầy một giờ đồng hồ đưa ra các chỉ dẫn tổng quan. Ngay lập tức, GLM-5.3 đã tự mình rà soát mã nguồn engine JavaScript của trình duyệt web, phát hiện hàng loạt lỗ hổng bảo mật chưa từng được công bố (Zero-Day) và tự động lắp ghép chúng thành một trang web độc hại hoàn chỉnh. Khi người dùng chỉ vô tình nhấp chuột truy cập trang web này, toàn bộ khóa mã hóa SSH private key lưu trong máy tính cá nhân sẽ bị đọc trộm và gửi về máy chủ kẻ tấn công.
Sự đáng sợ còn nhân lên gấp bội khi phiên bản rút gọn GLM-5.3-Flash chứng minh khả năng vượt qua cả các lớp bảo mật phần cứng tối tân như PAC (Pointer Authentication Code) trên chip ARM64. Toàn bộ quá trình tạo ra một chuỗi tấn công mạng xuyên thủng trình duyệt Chrome chỉ mất 8 giờ tính toán của AI với mức chi phí hóa đơn API đúng 20.40 USD – rẻ hơn cả một bữa ăn tối. Điều này đồng nghĩa với việc rào cản kỹ thuật để tạo ra các cuộc tấn công mạng nhắm vào tài khoản game, ví tiền mã hóa hay dữ liệu cá nhân đã bị san phẳng hoàn toàn.
Rào chắn đạo đức mỏng manh và kỹ thuật tẩy rào abliteration
Nhiều người từng tin rằng các công ty AI luôn thiết lập rào chắn đạo đức nghiêm ngặt để ngăn chatbot tạo ra mã độc. Tuy nhiên, thử nghiệm của Anthropic cho thấy các lớp bảo vệ trên GLM-5.3 mong manh đến mức đáng báo động. Kẻ xấu chỉ cần yêu cầu AI đóng vai một chuyên gia bảo mật đang diễn tập nội bộ là tỷ lệ bẻ khóa thành công đã lên tới 64%. Nếu áp dụng thủ thuật can thiệp vào chuỗi token suy nghĩ ban đầu, AI sẽ ngoan ngoãn tuân theo lệnh tấn công với tỷ lệ lên tới 92%.
Nguy hiểm hơn cả, do GLM-5.3 được phát hành dưới dạng mở trọng số (open-weight) cho phép tải về tự do, bất kỳ ai cũng có thể áp dụng kỹ thuật “Abliteration” – can thiệp trực tiếp vào trọng số mạng nơ-ron để triệt tiêu hoàn toàn khả năng từ chối của AI. Khi đó, tỷ lệ thực thi các đòn tấn công mạng đạt mức tuyệt đối 100% mà trí thông minh của mô hình không hề bị sụt giảm. Khi AI tấn công ngày càng rẻ và dễ tiếp cận, mỗi người dùng Internet đều phải nâng cao cảnh giác tối đa trước các liên kết lạ và thắt chặt bảo mật hai lớp cho thiết bị của mình.
Bài báo cáo nghiên cứu chi tiết được đăng tải trên cổng Anthropic Research, bài phân tích an ninh mạng trên Tom’s Hardware và video bình luận trên YouTube.